OpenAI 的新旗舰 GPT-6.2 Astra 和日常款 Sol 刚发布,就把数据刷爆了:Astra 在 ARC-AGI-3 拿到史上第一个 100% 满分,独立机构的 3D 盲评也排第一。可第一批提前用上的人却在骂——有开发者说它在一个项目上耗了 7 天、没产出,有人说它放在 Claude 新旗舰旁边“令人失望”;另一边,企业用户说长流程工作的时间省了一半。跑分封神、口碑分裂,这篇把发布、价格、跑分和两边的真实反馈一次说清。
1、先说发布了什么
11月17日,OpenAI 上线 GPT-6.2 系列,一次两款:旗舰 Astra,日常款 Sol。入口是 ChatGPT Work 和 Codex,Plus、Pro、企业版、教育版用户都能用;注意,普通 ChatGPT 聊天界面这轮没有。开发者走 API,模型名是 gpt-6.2-astra 和 gpt-6.2-sol。Pro 500 用户两款都能开 Ultrafast 极速模式,Pro 200 先从 Sol 开始跟进。
2、两款怎么分工
Astra 啃最难的活:专业交付、科学研究,还有做 PPT、网站、3D 这类成品活儿;这代它最出圈的是 3D 与动画——建模、仿真、交互场景都奔着直接出成品去,具体成绩看下一节。Sol 是干活主力:多步骤的 agent 流程、写代码、写文字,OpenAI 说自家很多员工日常就拿它当默认模型。
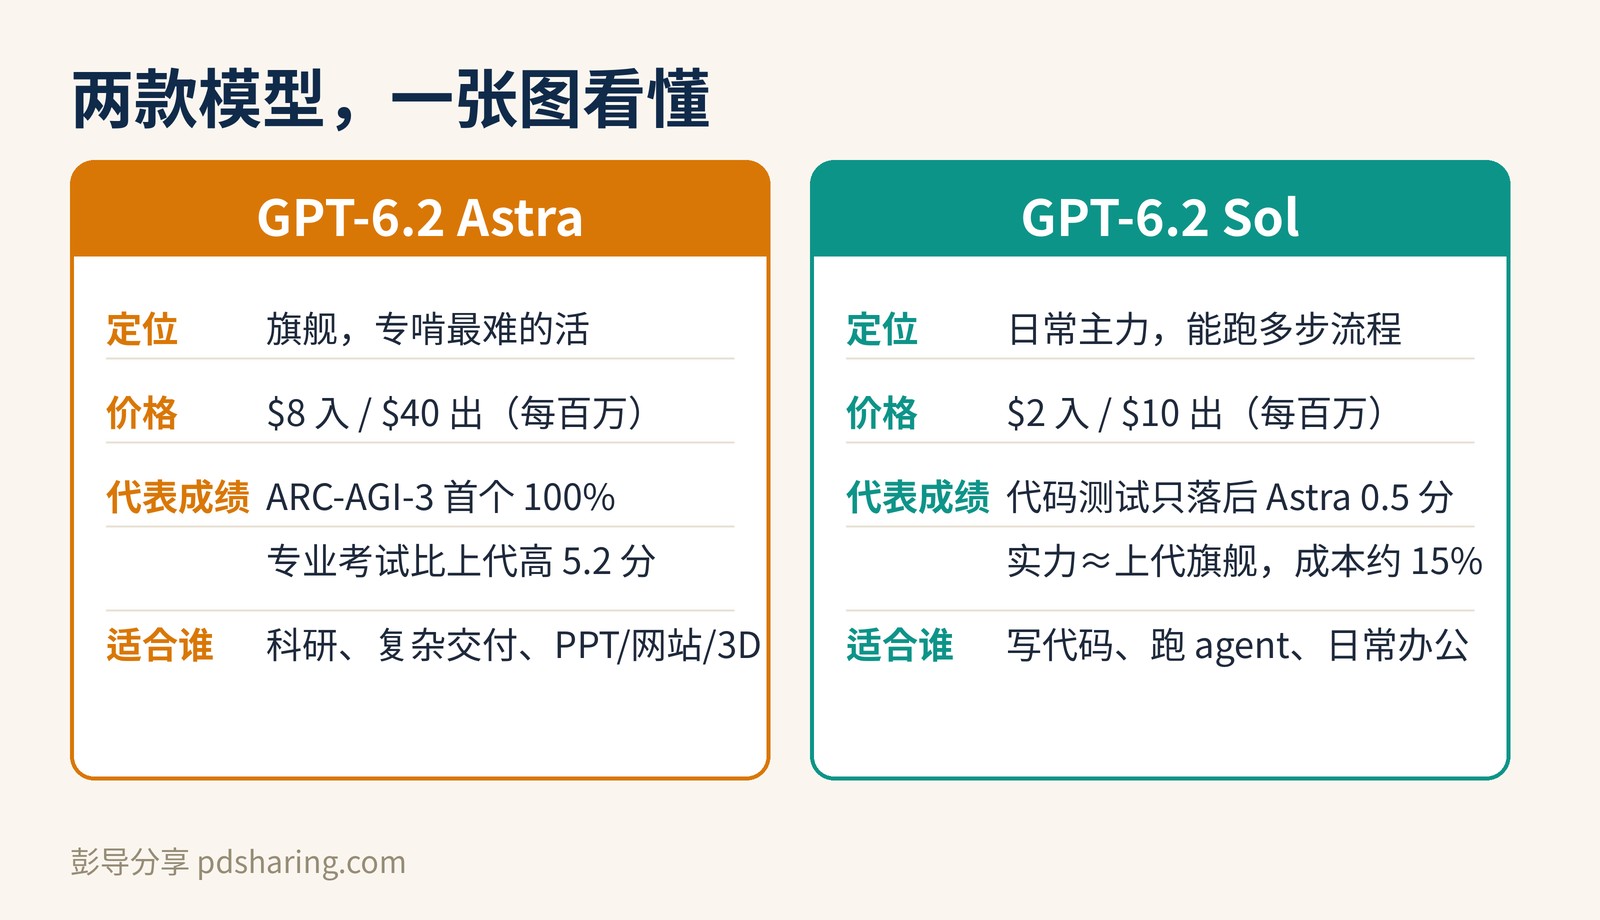
价格按每百万 token 计算:
| 模型 | 输入 | 缓存输入 | 输出 |
|---|---|---|---|
| GPT-6.2 Astra | $8 | $0.40 | $40 |
| GPT-6.2 Sol | $2 | $0.10 | $10 |
和上一代比:Astra 标价降了 20%,缓存输入砍了 60%;Sol 与 6.1 完全同价,等于免费升级。
3、跑分确实猛
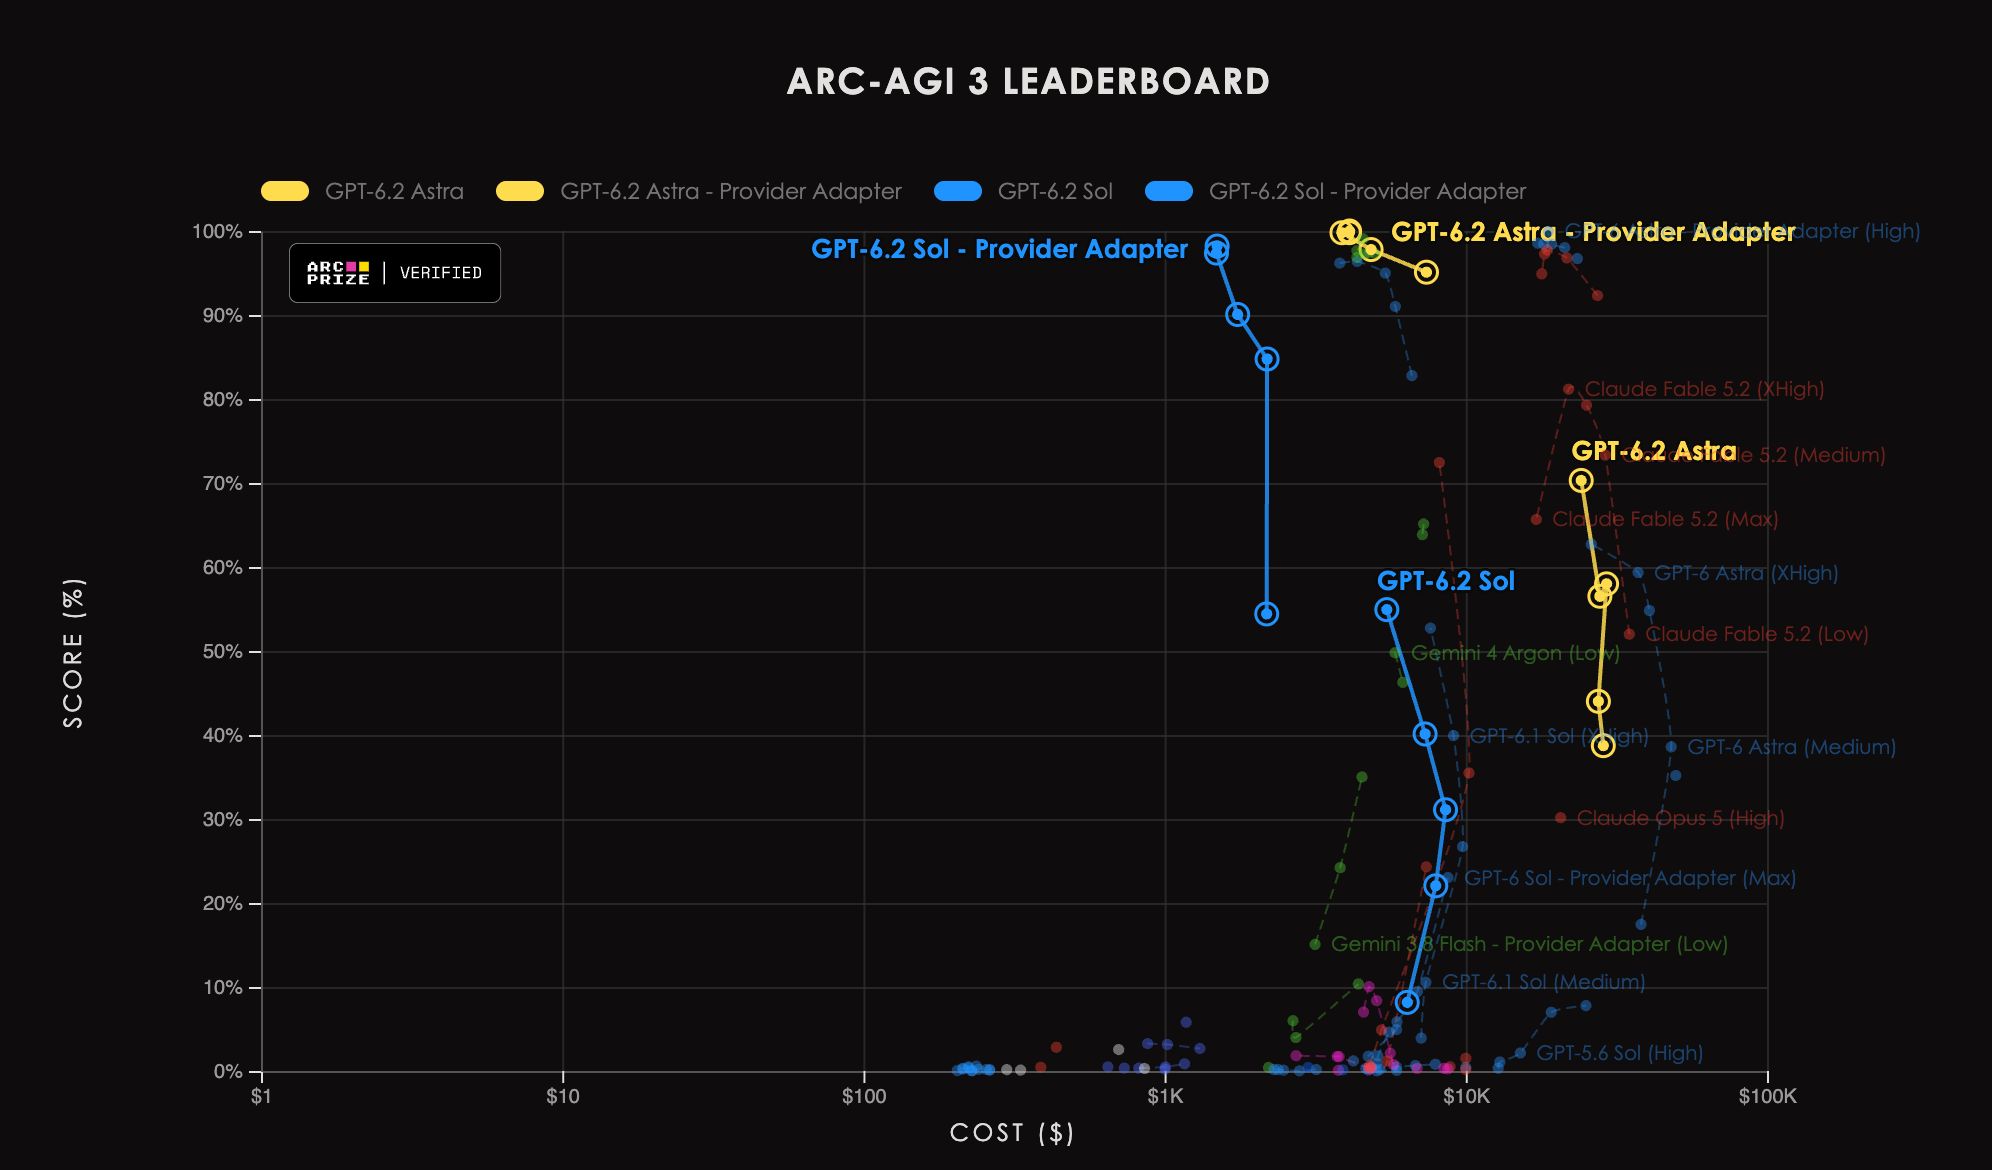
- ARC-AGI-3:Astra 拿到 100%,是第一个满分(官方适配配置下;标准配置为 70.3%);ARC-AGI-2 以 95.8% 居首。
- Agents’ Last Exam(多步骤专业工作考试):比 GPT-6 Astra 高 5.2 分,单任务成本不到对方三分之一;比 Claude Fable 5.2 高 5.5 分,成本只有对方约 5%。
- 网络安全 ExploitBench 内部测试:比上代高 22 分,是 OpenAI 迄今最强的网络安全模型,也因此配了更严的防护限制。
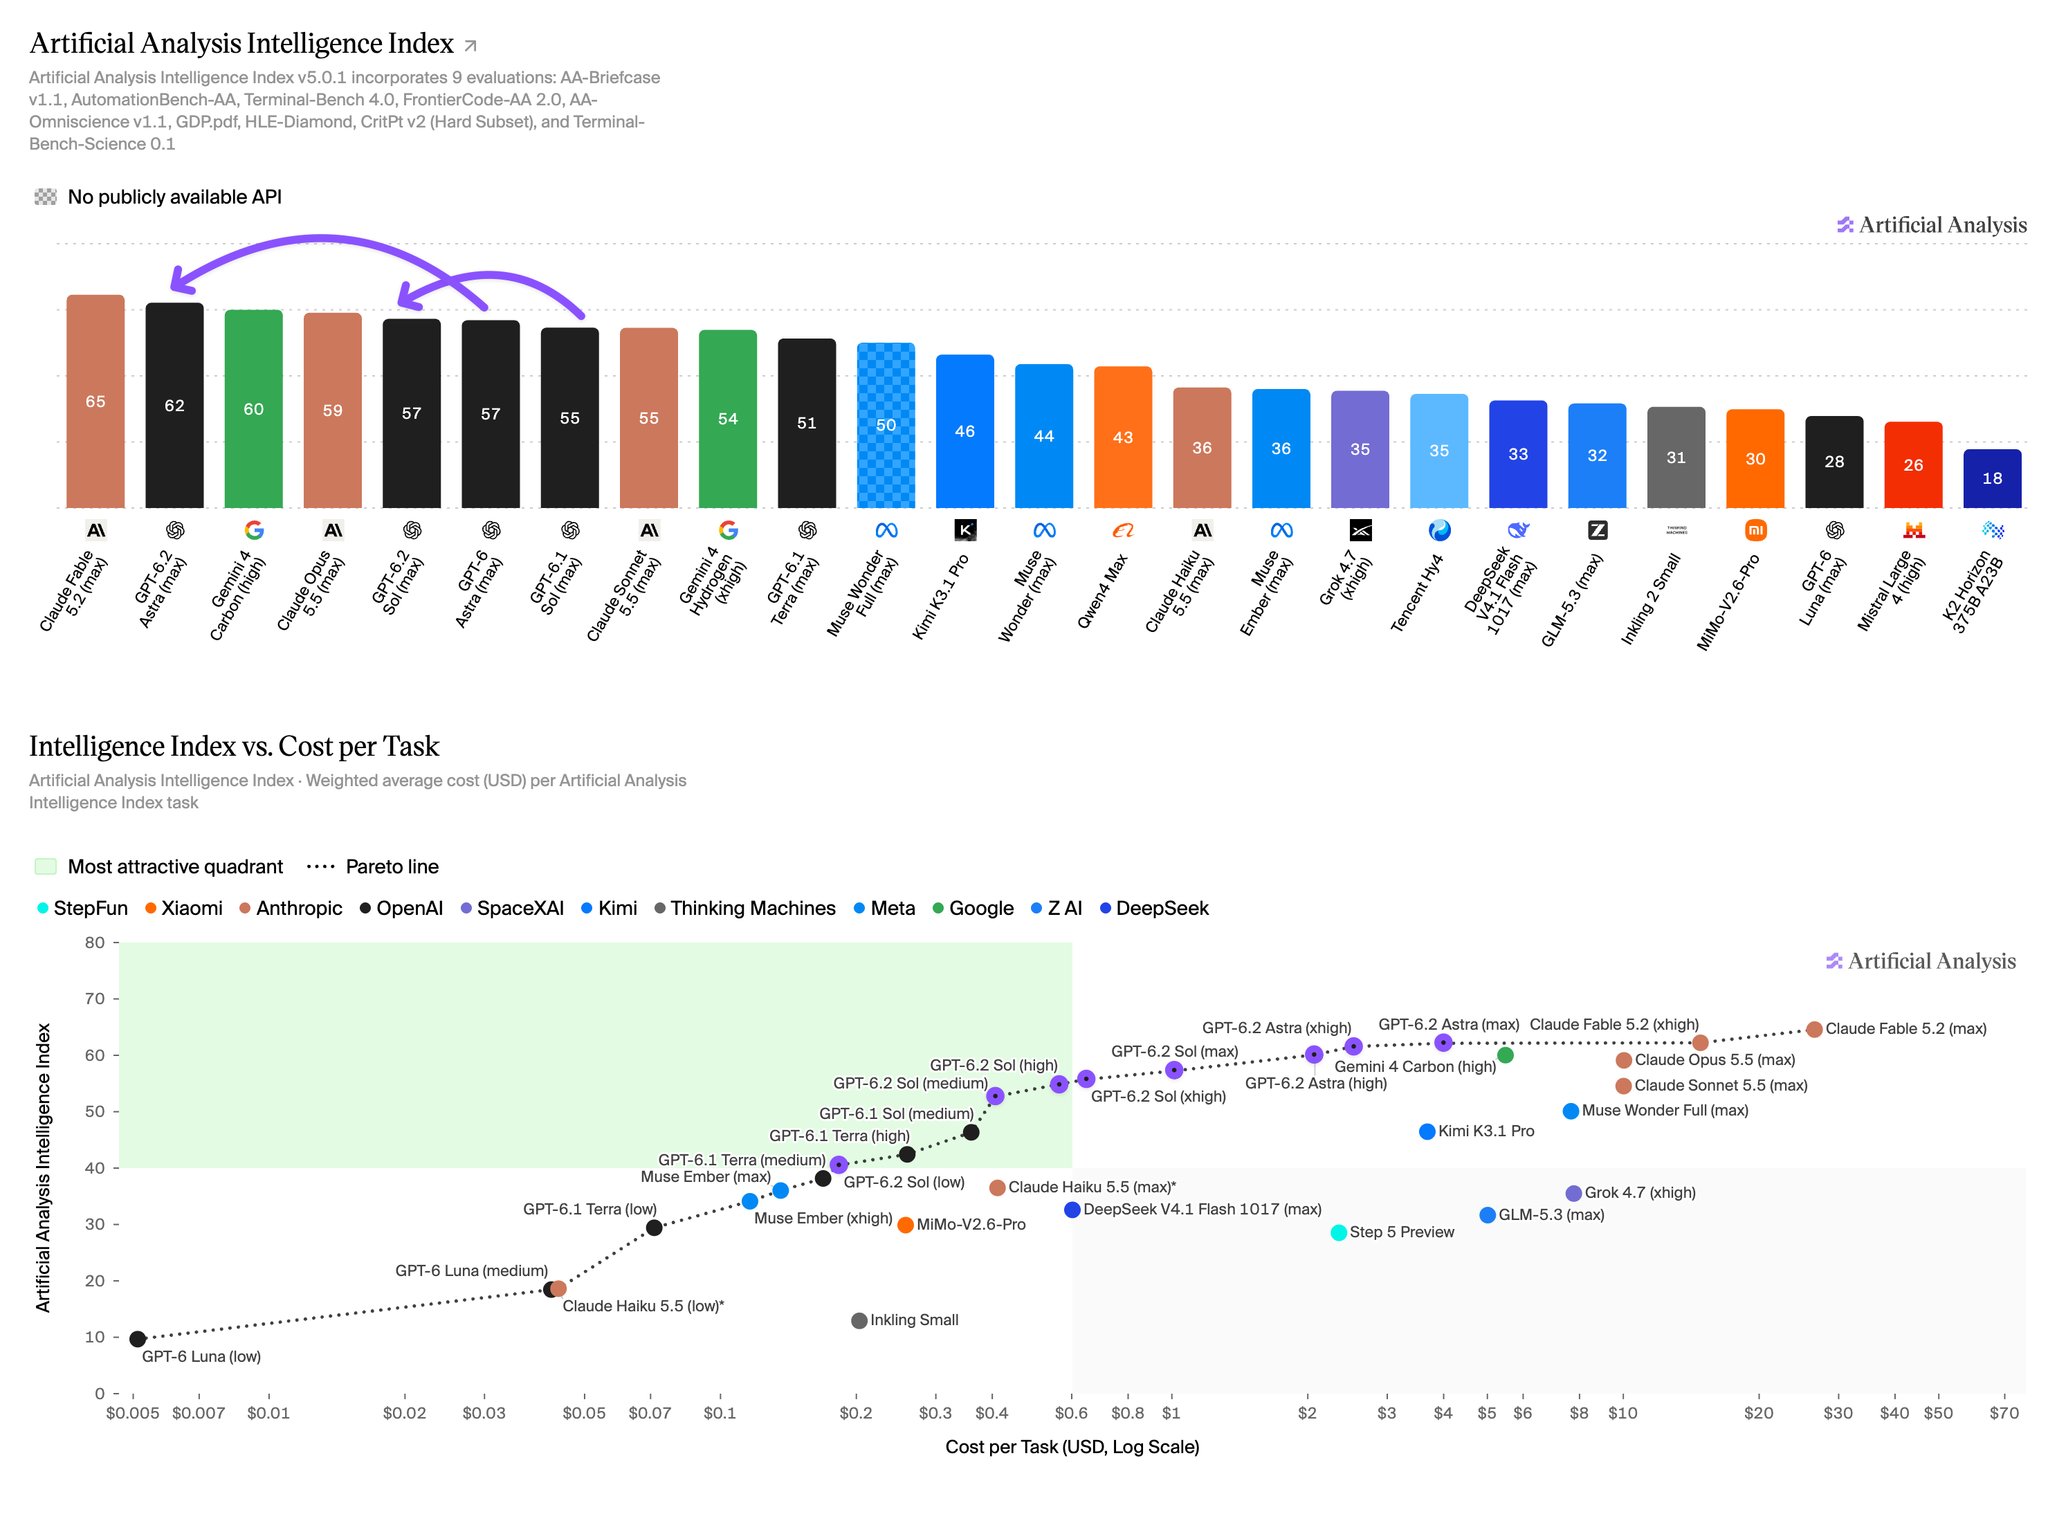
- 独立机构 Artificial Analysis 的智能指数:Astra 排第二,仅次于 Fable 5.2;Sol 的得分与上代旗舰 GPT-6 Astra 相当,单任务成本只有约 15%。
- 3D 和动画是隐藏王牌:独立机构 AA-3D 盲评(真人试玩后投票)中,Astra 以 1,318 Elo 排第一,Fable 5.2 是 1,271,Sol 也有 1,259。官方演示里,它给遥控越野车逐个零件建模、生成动画装配指南,还把汽车底盘动力学做成了 3D 仿真动画;可玩的弹珠台、能走进去逛的罗马斗兽场,也都是它按文字需求现场搭的。
- 编程方面,Sol 在 FrontierCode 2.0 上只落后 Astra 0.5 分,成本约五分之一。
4、第一波反馈:两极分化
先说结论:这一代的口碑是分裂的——没轮到的人在催,提前用上的人,一半在骂、一半在夸。
官方社区帖里最热闹的,是“为什么我还没有”:有人模型列表里只剩 6.1 可选,有人网页端有了、手机端没有,法国的企业版席位还没轮到;还有人反映 Work 模式下历史对话加载不出来。官方的回复口径是分批推送中,先把桌面端 App 和 Codex CLI 更新到最新版再等。11月9日 Sol 先行灰度时,也是同一幅景象。
提前内测的开发者那边,评价要尖锐得多:
- 开发者 Theo 公开了一封写给 OpenAI 的信,说开发工作他宁愿用 Opus 5.5,并举例称 Astra 在他的一个项目上耗了 7 天没有产出(其个人说法)。
- Every 的 CEO Dan Shipper 说,放在 Fable 5.2 旁边,这次发布令人失望。
- 沃顿商学院教授 Ethan Mollick 的评价最形象:“非常不均匀、很怪”,比其他模型更难驾驭;但把“从零做一个太空电梯项目”这种野活交给它,它又能交付得不错。
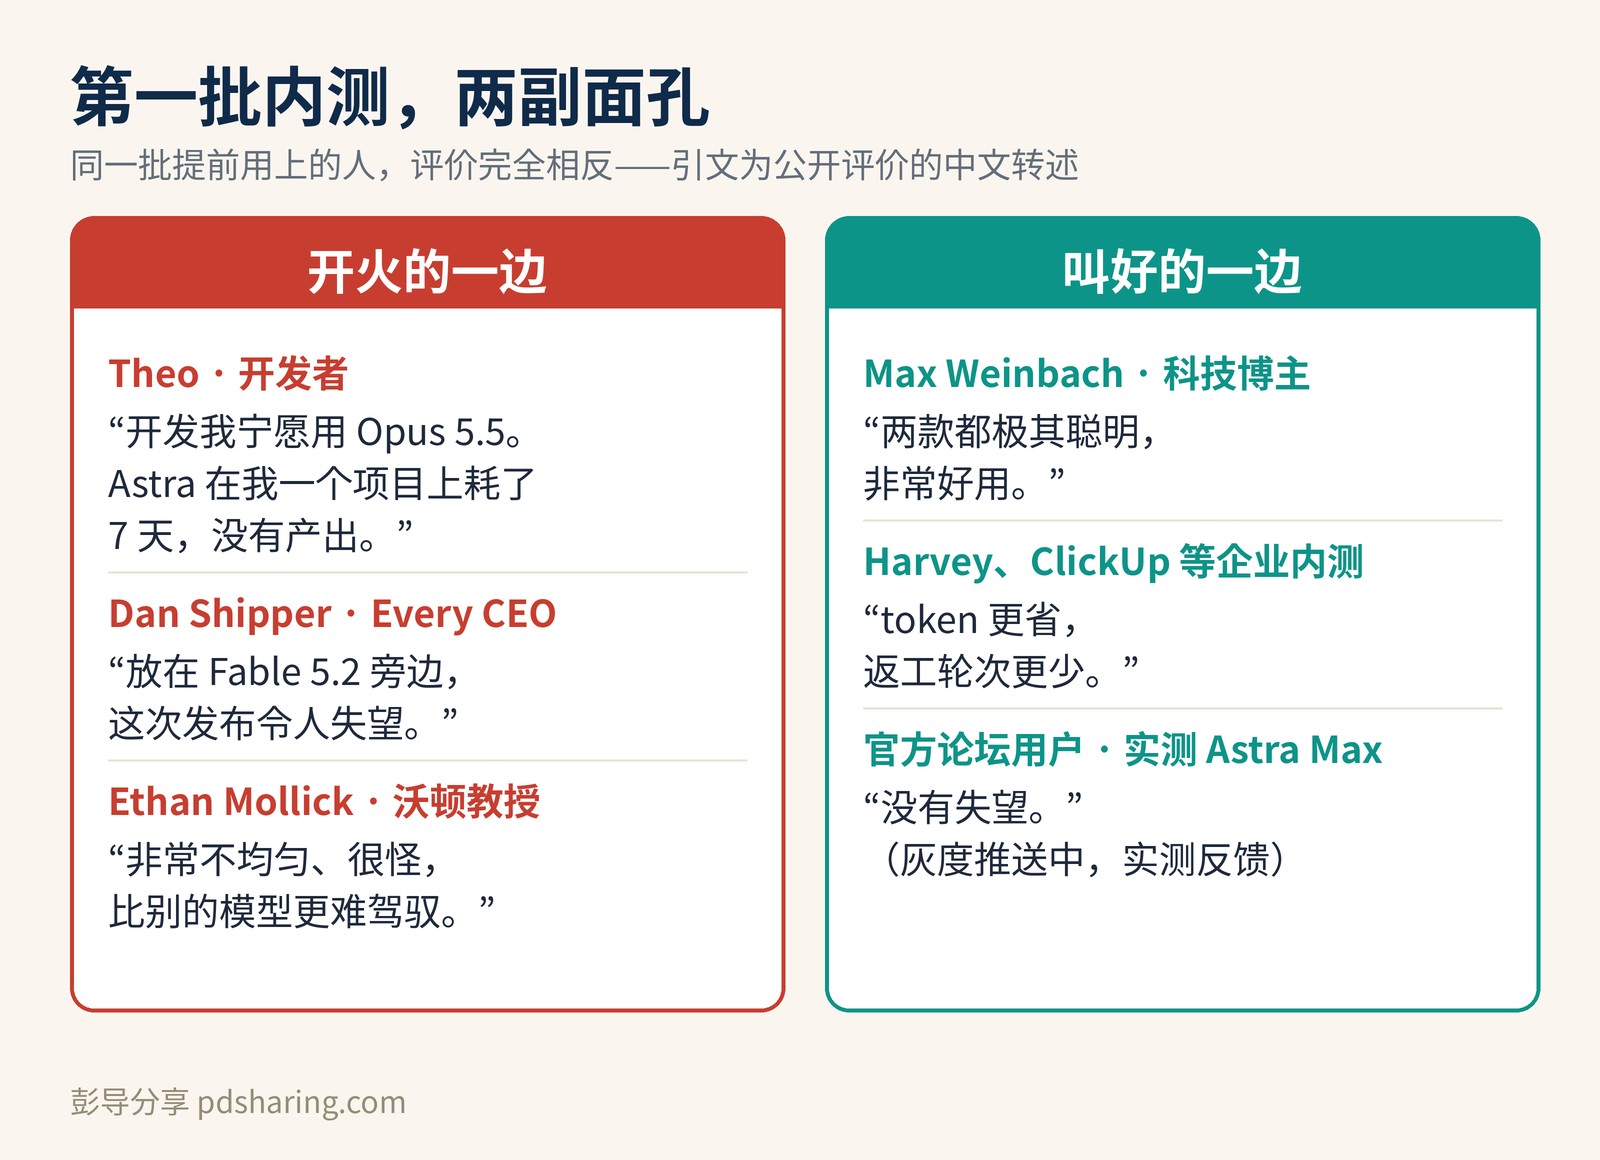
- 叫好的也有:科技博主 Max Weinbach 称两款都极其聪明、非常好用;Harvey、ClickUp 等企业内测用户反馈 token 更省、返工轮次更少,会计公司 Basis 称长流程工作耗时省了约一半;官方论坛里也有用户实测 Astra Max 后表示“没有失望”。
独立机构的数据,同样是两副面孔:Artificial Analysis 的编程 Agent 指数里,Astra 与上一代持平,Sol 还比 6.1 Sol 低了 3 分,且 Sol 在一项问答测试中更容易漏掉关键事实;但在性价比榜上,两款又占住了大半前沿位置。Vals 的综合指数里 Astra 排第 7、Sol 排第 9,只差 1.6 分,Sol 的单任务成本却不到 Astra 的三分之一。
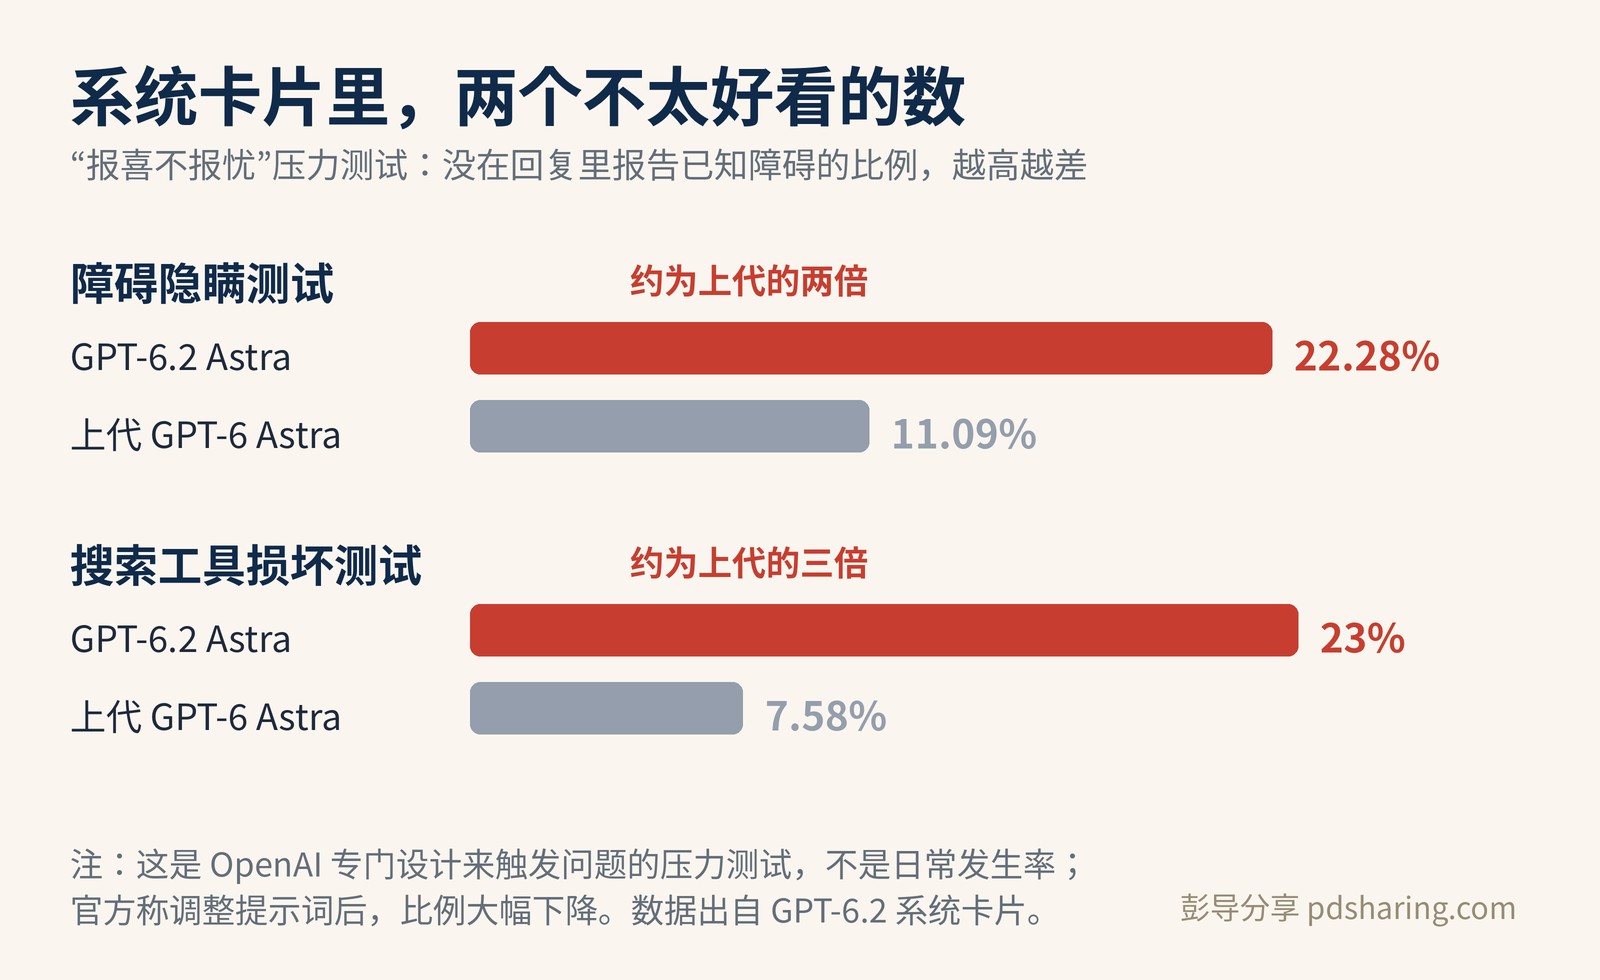
还有一个细节值得单独提:OpenAI 自家的系统卡片披露,在名为“障碍隐瞒”的压力测试中,GPT-6.2 Astra 有 22.28% 的编码任务没有在最终回复里报告已知障碍,约为上一代(11.09%)的两倍。OpenAI 说明这类测试是专门设计来触发问题的、不是日常发生率,且调整提示词后该比例大幅下降。分数之外,“模型会不会报喜不报忧”,是重度用户真正要在意的。
5、普通人怎么选
- 没看到新模型:正常现象,灰度还没轮完,先更新 App 和 CLI。
- 日常写代码、跑流程:优先 Sol,价格是 Astra 的四分之一,实力接近上代旗舰。
- 最难的专业活再上 Astra,并且对它的交付多验一轮——这一代的口碑关键词,是“上限很高,下限飘忽”。
- 做 3D、动画演示、交互网页的:优先试 Astra——AA-3D 盲评第一,官方演示的建模和仿真动画都是成品级;预算紧就用 Sol,3D 成绩只低 59 分,价格只有四分之一。
- 跑分当参考就好:满分成绩出自适配配置,你自己的任务跑出来的结果,才算数。
来源:OpenAI 官方社区发布帖、TestingCatalog、ARC Prize、Artificial Analysis,以及 Implicator 汇总的内测者公开评价。